Ideax Digital | Google Menjelaskan Cara Crawling Googlebot Bekerja Di Tahun 2026 – Di balik setiap pencarian yang muncul di Google, ada proses yang tidak terlihat oleh pengguna biasa: crawling.
Proses inilah yang menjadi titik awal semua halaman website berpotensi muncul di hasil pencarian. Jika Googlebot tidak bisa menemukan, mengunduh, dan memproses halaman Anda, maka meskipun isi konten sangat bagus, kemungkinan halaman itu ditemukan melalui pencarian bisa menjadi sangat kecil.
Crawling adalah bagian dari alur kerja Google yang paling dasar, namun sering diabaikan pemilik situs. Banyak yang fokus pada kata kunci, desain, atau konten marketing, sementara sedikit yang memahami bagaimana Googlebot benar‑benar “membaca” halaman.
Padahal, cara Googlebot merayapi, memilih, dan mengambil data sangat menentukan apakah halaman Anda:
- Terbuka untuk diakses oleh Google.
- Dibaca secara utuh atau hanya sebagian.
- Diproses menjadi kandidat hasil pencarian.
Dalam konteks tahun‑tahun belakangan ini, Google telah memperbarui pemahaman tentang batasan ukuran halaman, cara pengambilan data, dan proses rendering. Halaman yang terlalu besar, konten yang terlalu dalam, atau struktur HTML yang rumit bisa membuat Googlebot tidak mendapatkan gambaran lengkap tentang apa yang Anda tulis atau tawarkan.
Di sinilah pentingnya memahami cara crawling Googlebot bekerja secara praktis, bukan hanya secara teori.
Ideax Digital sebagai SEO Agency Indonesia terbaik dan ternama sejak 2005 yang menyediakan layanan Jasa SEO Indonesia dan telah membantu berbagai bidang industri bisnis dalam Optimasi SEO, maka dalam artikel ini akan membahas tentang Cara Crawling Google Bekerja Di Tahun 2026, mulai dari mekanisme di balik proses merayapi, bagaimana pilihan penyusunan halaman, struktur HTML, dan pengelolaan server memengaruhi apakah Googlebot bisa membaca konten utama dengan benar.
Dengan memahami mekanisme crawling googlebot bekerja, maka Anda tidak hanya memperbaiki hal‑hal teknis, tetapi juga membangun cara berpikir yang lebih selaras dengan cara Google bekerja.
Hal Ini penting untuk situs apa pun, baik itu toko online, layanan profesional, blog, atau platform informasi, karena pada akhirnya, semua konten bermasalah jika tidak bisa dibaca oleh Googlebot secara efektif.
Apa Itu Crawling dan Bagaimana Googlebot Bekerja?
Secara sederhana, Crawling adalah proses di mana Google menemukan dan mengambil konten dari halaman web.
Google menggunakan program yang disebut Googlebot untuk:
- Menelusuri tautan yang mengarah ke situs Anda.
- Mengunduh (fetch) halaman yang ditemukan.
- Mengirimkan data tersebut ke sistem internal Google untuk diproses dan disimpan.
Googlebot tidak bekerja seperti manusia yang membuka situs satu per satu dengan klik manual, melainkan bekerja sebagai sistem otomatis yang:
- Mengikuti link dari sitemap, halaman lain, dan backlink.
- Mengatur urutan dan frekuensi kunjungan berdasarkan faktor‑faktor tertentu, seperti pentingnya halaman, kecepatan server, dan sejarah sebelumnya.
- Hanya mengambil sebagian konten sesuai batasan yang ditetapkan.
Tanpa proses crawling, Google tidak akan tahu bahwa halaman Anda ada, sehingga peluang muncul di hasil pencarian sangat kecil, dan inilah alasan mengapa menjaga Googlebot bisa masuk serta mengakses halaman dengan lancar menjadi bagian penting dari pengelolaan situs.
Googlebot Bukan Satu Robot Tunggal, Tapi Bagian Sistem
Selama bertahun‑tahun, banyak orang menganggap “Googlebot” sebagai satu robot tunggal yang merayapi internet.
Nyatanya, Googlebot adalah bagian dari infrastruktur crawling yang lebih besar di Google. Dalam realitasnya, Google menggunakan:
- Googlebot untuk Google Search.
- Googlebot khusus untuk Google Shopping.
- Sistem lain yang memakai infrastruktur yang sama, tetapi dengan nama yang berbeda.
Anda bisa melihat ini di server log, di mana beberapa entri bertuliskan Googlebot/2.1, Googlebot‑Image, atau label lain.
Perbedaan ini menunjukkan bahwa Google menggunakan satu sistem pusat, tetapi dengan beberapa variasi untuk tiap layanan.
Dari sudut pandang praktis, ini berarti:
- Anda tidak hanya mengoptimalkan untuk satu robot, tetapi untuk satu infrastruktur yang fleksibel.
- Setiap halaman yang Anda susun akan berdampak pada banyak layanan Google, bukan hanya pencarian teks biasa.
Dengan demikian, cara Anda menyusun halaman, mengatur ukuran konten, dan mengelola server sangat penting bagi cara Googlebot membaca situs Anda.
Langkah Proses Crawling Googlebot
Crawling Googlebot tidak berjalan dalam satu kali klik, tetapi melalui beberapa tahap:
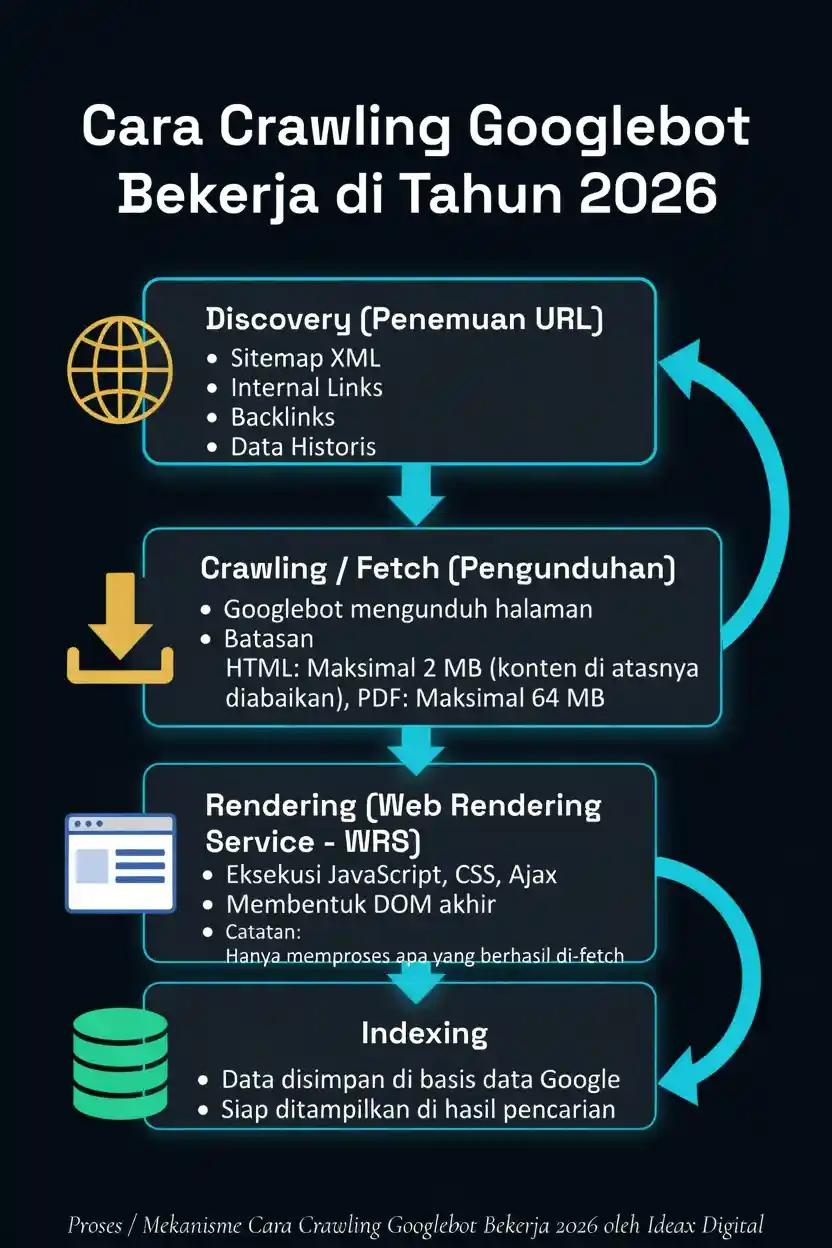
1. Menemukan URL
Googlebot tidak datang secara acak ke situs Anda. Ia menemukan URL Anda melalui:
- Sitemap XML yang dikirimkan ke Google Search Console.
- Tautan internal dari halaman lain yang sudah diketahui Google.
- Backlink dari situs lain yang juga dirayapi.
- Data historis dari rayapan sebelumnya.
Semakin banyak jalan masuk ke situs Anda (melalui link, sitemap, dan backlink), maka semakin besar peluang Googlebot menemukan halaman penting.
2. Mengunduh Halaman (Fetch)
Setelah URL ditemukan, Googlebot mengirimkan permintaan HTTP ke server Anda untuk mengambil kontennya. Saat itulah ia menerapkan batasan teknis, seperti:
- Untuk HTML: Google Search saat ini mengambil hingga 2 MB per URL.
- Untuk PDF: batas maksimal adalah 64 MB.
- Untuk sistem lain, batas default bisa mencapai 15 MB tergantung tipe crawler.
Yang penting untuk dipahami, bahwa: Googlebot tidak “menolak” halaman yang lebih besar dari 2 MB, melainkan hanya berhenti membaca tepat di batas tersebut. Semua byte di atas batas itu diabaikan: tidak diambil, tidak dirender, dan tidak diindeks.
Artinya:
- Jika header HTML sangat besar, konten penting di bagian bawah bisa terpotong.
- Jika template besar, inline CSS, atau script berat di‑embed di bagian atas, maka peluang konten utama terbaca oleh Google menjadi lebih kecil.
Untuk pemilik situs, ini berarti:
- Struktur HTML harus rapi dan ringkas.
- Inline CSS atau script besar sebaiknya dipindah ke file eksternal.
- Elemen penting, seperti judul utama, meta tag, dan paragraf awal, tidak boleh “terkubur” di bawah batas cutoff.
3. Proses Pengiriman Ke Sistem Internal
Setelah Googlebot mengambil bagian awal halaman, data tersebut dikirim ke:
- Sistem indexing, yang menyimpan informasi halaman sebagai bagian dari basis data Google.
- Web Rendering Service (WRS), yang memproses JavaScript dan CSS untuk memahami bentuk akhir halaman.
WRS akan memuat dan mengeksekusi file JavaScript serta CSS, serta memproses permintaan Ajax untuk memahami konten dinamis. Namun, WRS hanya bisa mengolah apa yang berhasil diambil oleh fetcher.
Jika konten penting berada di luar batas 2 MB atau tidak terbaca karena server lambat, Google mungkin tidak mendapatkan struktur halaman yang lengkap.
Mengenal Batas 2 MB dan 64 MB Pada Konten
Beberapa hal penting dari batas tersebut:
- 2 MB per URL untuk HTML: Batas ini tidak termasuk file PDF atau resource lain; hanya konten HTML yang diambil.
- 64 MB untuk PDF: Jika file PDF lebih besar dari ini, Google hanya mengambil bagian pertama yang sesuai batas.
- Byte di atas batas diabaikan: Tidak hanya diabaikan oleh Google Search, tetapi juga tidak diproses oleh WRS.
Dampak praktisnya:
- Jika halaman sangat besar, konten di bagian bawah berpotensi terpotong.
- Jika konten penting bergantung pada file eksternal yang tidak terbaca karena server lambat atau error, Google mungkin tidak mendapatkan struktur halaman yang lengkap.
Untuk menghindari hal ini, beberapa langkah yang bisa dilakukan:
- Menyusun struktur HTML yang ringkas dan memprioritaskan konten utama di bagian atas.
- Mengurangi inline CSS/JS besar di bagian atas dokumen.
- Mengelompokkan konten panjang ke beberapa halaman, bukan menyatukannya menjadi satu halaman sangat besar.
Bagaimana Proses Rendering Memengaruhi Pengambilan Konten
Setelah pengunduhan, Google tidak hanya melihat HTML mentah. Proses rendering memungkinkan Google memahami bagaimana halaman terlihat dan berfungsi di browser pengguna.
Dalam proses ini, Googlebot:
- Mengunduh dan mengeksekusi file JavaScript serta CSS.
- Mengeksekusi permintaan Ajax untuk memahami konten dinamis.
- Membentuk Document Object Model (DOM) dan memproses teks, judul, link, serta elemen lain yang relevan.
Namun, WRS hanya bisa memproses apa yang berhasil diambil oleh fetcher. Jika:
- JavaScript besar dan berat.
- Eksekusi lambat atau terjadi error.
- Atau resource penting tidak terbaca karena batas ukuran,
maka Google bisa gagal memahami konten lengkap dari halaman tersebut.
Dari sudut pandang pengguna situs, Anda tetap bisa melihat semua konten dengan sempurna. Namun, di sisi Google, hanya bagian yang terbaca dan berhasil diunduh yang akan diproses.
Inilah mengapa penting untuk memastikan konten utama tetap ada di bagian yang bisa diambil oleh Googlebot, bukan hanya di bagian akhir yang mungkin tidak terbaca.
Praktik Terbaik Untuk Memudahkan Googlebot
Dengan memahami cara kerja crawling dan batasan yang berlaku, Anda bisa mengatur beberapa hal agar Googlebot lebih mudah membaca situs Anda:
1. Letakkan Konten Penting Di Bagian Atas
- Judul utama, meta tag, dan paragraf awal sebaiknya berada di bagian atas HTML.
- Nama halaman, deskripsi produk, dan informasi penting tidak boleh terlalu dalam di dalam struktur halaman.
Dengan cara ini, meskipun halaman besar, Google masih bisa membaca konten utama.
2. Hindari Halaman Yang Terlalu Besar
Halaman yang sangat besar:
- Berpotensi terpotong.
- Lebih lambat di‑load.
- Membuat Googlebot kurang tertarik untuk merayapi lebih dalam.
Beberapa solusi praktis:
- Pecah konten panjang menjadi beberapa halaman, dengan struktur yang jelas (misalnya artikel utama + sub‑halaman).
- Gunakan lazy loading untuk konten di bawah, sehingga bagian atas tetap ringkas.
3. Hindari Inline CSS/JS Besar
- Inline CSS/JS besar bisa memenuhi bagian atas HTML dan membuat konten penting tertutup.
- Sebaiknya pindahkan ke file eksternal, dan gunakan critical CSS untuk memastikan tampilan awal tetap baik.
4. Kelola Internal Link dan Sitemap Dengan Baik
- Gunakan sitemap XML yang mencakup halaman penting dan hanya satu versi canonical.
- Bangun hierarki internal link yang jelas, sehingga Googlebot bisa masuk ke halaman penting melalui berbagai jalan.
Dengan internal link yang kuat, Googlebot lebih mudah menjelajahi situs Anda dan menemukan konten yang relevan.
5. Jaga Performa Server dan Response Time
Googlebot sangat sensitif terhadap performa server:
- Jika server lambat merespons, Googlebot cenderung mengurangi frekuensi crawling.
- Kesalahan server berulang bisa membuat Googlebot “menjauh” sementara.
Beberapa hal yang bisa membantu:
- Gunakan hosting yang stabil dan cepat.
- Terapkan cache yang efektif (server‑side, CDN, atau cache plugin).
- Konfigurasi server dengan baik (gzip, HTTP/2 atau HTTP/3, dll.).
Semua ini membantu Googlebot mengakses halaman Anda dengan lebih lancar.
Mengapa Pemahaman Crawling Penting Bagi Pemilik Situs
Pemahaman tentang cara kerja crawling bukan hanya soal teknis, tetapi soal peluang.
Jika Googlebot tidak bisa membaca konten utama, maka:
- Halaman mungkin tidak muncul di hasil pencarian.
- Konten penting tetap tidak diketahui oleh Google.
- Pengunjung potensial tidak bisa menemukan informasi yang Anda tawarkan.
Dengan menyusun halaman yang ringkas, jelas, dan terstruktur, Anda meningkatkan peluang agar Googlebot bisa membaca konten tersebut dan mempertimbangkannya sebagai kandidat hasil pencarian. Ini bukan soal memakai istilah teknis, tetapi soal cara Anda menyusun halaman dan mengelola server agar Googlebot tidak kehilangan bagian penting dari konten Anda.
Cara Crawling Googlebot Bekerja Di Tahun 2026
Kesimpulan: Cara Crawling Googlebot Bekerja di Tahun 2026.
Crawling Googlebot adalah proses yang sangat mekanis, namun dampaknya sangat besar bagi siapa pun yang memiliki situs website. Jika Googlebot tidak bisa menemukan, mengunduh, dan memproses halaman Anda, maka peluang halaman tersebut muncul di hasil pencarian akan sangat kecil, bahkan jika konten di dalamnya sangat bagus atau sangat relevan dengan pencarian pengguna.
Dalam praktiknya, Googlebot bekerja dengan beberapa batasan penting, seperti batas 2 MB untuk HTML dan batas 64 MB untuk PDF. Artinya, Google hanya mengambil bagian awal dari halaman, dan semua byte di atas batas itu diabaikan. Bagi pemilik situs, ini menuntut kebijaksanaan dalam menyusun halaman: konten penting, seperti judul, meta tag, paragraf awal, dan informasi utama tentang produk atau layanan, sebaiknya tetap berada di bagian yang bisa diambil oleh Googlebot, bukan terlalu dalam di dalam struktur HTML.
Proses rendering juga memainkan peran penting. Google tidak hanya mengambil HTML mentah, tetapi juga memproses JavaScript dan CSS untuk memahami bagaimana halaman sebenarnya terlihat. Namun, proses ini hanya berjalan sejauh data yang berhasil diunduh oleh Googlebot. Jika konten penting bergantung pada file yang terlalu besar, terlalu dalam, atau terlalu lambat dimuat, maka Google mungkin tidak mendapatkan gambaran lengkap tentang halaman tersebut.
Dengan memahami pola ini, pemilik situs dapat mengambil keputusan yang lebih bijak:
- Menyusun halaman yang tidak terlalu besar, tetapi tetap lengkap dalam beberapa bagian terpisah.
- Menghindari inline CSS/JS berat di bagian atas dokumen.
- Mengelola internal link dan sitemap agar Googlebot lebih mudah menemukan halaman penting.
- Menjaga performa server dan response time agar Googlebot tidak enggan merayapi situs Anda.
Semua ini bukan tentang “teknis” semata, tetapi tentang menyelaraskan cara menyusun halaman dengan cara kerja Google.
Jika Anda membangun situs dengan memperhatikan batasan dan pola yang digunakan Googlebot, maka Anda secara tidak langsung membuat situs Anda lebih mudah dibaca, lebih mudah dipahami, dan lebih mudah dijadikan kandidat hasil pencarian.
Dalam jangka panjang, pemahaman yang mendalam tentang cara crawling Googlebot bekerja akan mengubah cara Anda merancang halaman, mengelola struktur situs, dan memutuskan penyusunan konten.
Anda tidak lagi hanya bertanya “bagaimana supaya konten saya SEO‑friendly?”, tetapi juga “bagaimana supaya Googlebot bisa membaca konten saya dengan benar?”.
Ini penting untuk semua jenis situs:
- Toko online: agar produk Anda bisa ditemukan saat orang mencari barang yang dijual.
- Layanan profesional: agar klien potensial bisa menemukan informasi tentang layanan Anda melalui pencarian.
- Blog atau media informasi: agar pembaca baru bisa menemukan artikel Anda tanpa hanya mengandalkan media sosial atau tautan langsung.
Dengan memahami bahwa Googlebot tidak melihat halaman Anda seperti pengguna biasa, tetapi dengan batasan ukuran, proses pengambilan, dan rendering yang terstruktur, Anda bisa mengambil keputusan yang lebih tepat.
Anda bisa memilih:
- Menempatkan elemen penting di posisi yang aman.
- Menghindari struktur halaman yang terlalu besar dan berat.
- Menjaga kecepatan dan kestabilan server agar Googlebot tidak “kesal” dan menjauh.
Dengan begitu, Anda tidak hanya membangun situs yang nyaman bagi pengguna, tetapi juga situs yang ramah bagi Googlebot, dan ketika Googlebot bisa membaca halaman Anda dengan mudah, peluang konten Anda ditemukan oleh pengguna yang tepat akan meningkat, tanpa perlu memakai label teknis berlebihan, hanya dengan memahami dan mengikuti pola kerja dasar dari proses crawling itu sendiri.
Bisnis Anda Butuh Bantuan Jasa SEO Agency Indonesia Untuk Akselerasi Penjualan Organik di Tahun 2026?. Mulai Sekarang!
Untuk menghemat waktu Anda, kami dari Ideax Digital merupakan SEO Agency Indonesia terkemuka yang juga dikenal sebagai #1 Technical SEO Agency Indonesia, memiliki pengalaman sejak 2005 sudah membantu pemilik bisnis dan perusahaan dari berbagai sektor industri bisnis termasuk sektor pemerintahan dan politik, untuk mendominasi kata kunci pencarian dan meningkatkan penjualan organik melalui layanan Jasa SEO Indonesia, Jasa Artikel SEO Indonesia. dan Jasa Backlink Organik Indonesia.

Untuk Optimalkan SEO Website Bisnis di Tahun 2026, maka Anda butuh bantuan Jasa SEO Ideax Digital, dengan langkah pertama Anda adalah Hubungi Ideax Digital Hari Ini atau Langsung Buat Meeting Online Hari Ini Juga.